Part 3. AI 기반 수업 분석과 개선
이전 장에서는 Hermes의 작업범위를 Second-Brain에서 Web으로 확장하고, 교수자의 기존 연구기록과 현재 외부 정보를 함께 탐색하는 과정을 확인하였음
이번 장에서는 연구 업무에서 수업 업무로 작업범위를 확장함.
- 강의계획서와 기존 강의자료 탐색
- 학생 질문과 수업회고 분석
- Excel에 저장된 학습데이터 분석
- 다수 학생 리포트와 평가기준 확인
- 반복되는 학습 취약점 발견
- Web에서 최신 사례와 보완자료 탐색
- 분석 결과를 반영한 수업 개선안 작성
- 결과를 다시
Second-Brain에 저장
이번 장에서 새롭게 중요한 역할을 하는 기능은 Tool / Code임.
단, Python 코드를 배우는 것이 목적은 아님.
문장의 의미를 이해해야 하는 작업
        ↓
       LLM

정확하게 계산해야 하는 작업
        ↓
   Tool / Code

현재 외부 자료가 필요한 작업
        ↓
   Web / Browser

필요한 로컬 자료를 찾아야 하는 작업
        ↓
 File Operations

전체 작업의 목표를 판단하고
필요한 기능을 선택
        ↓
   Hermes Agent
이번 장의 전체 흐름:
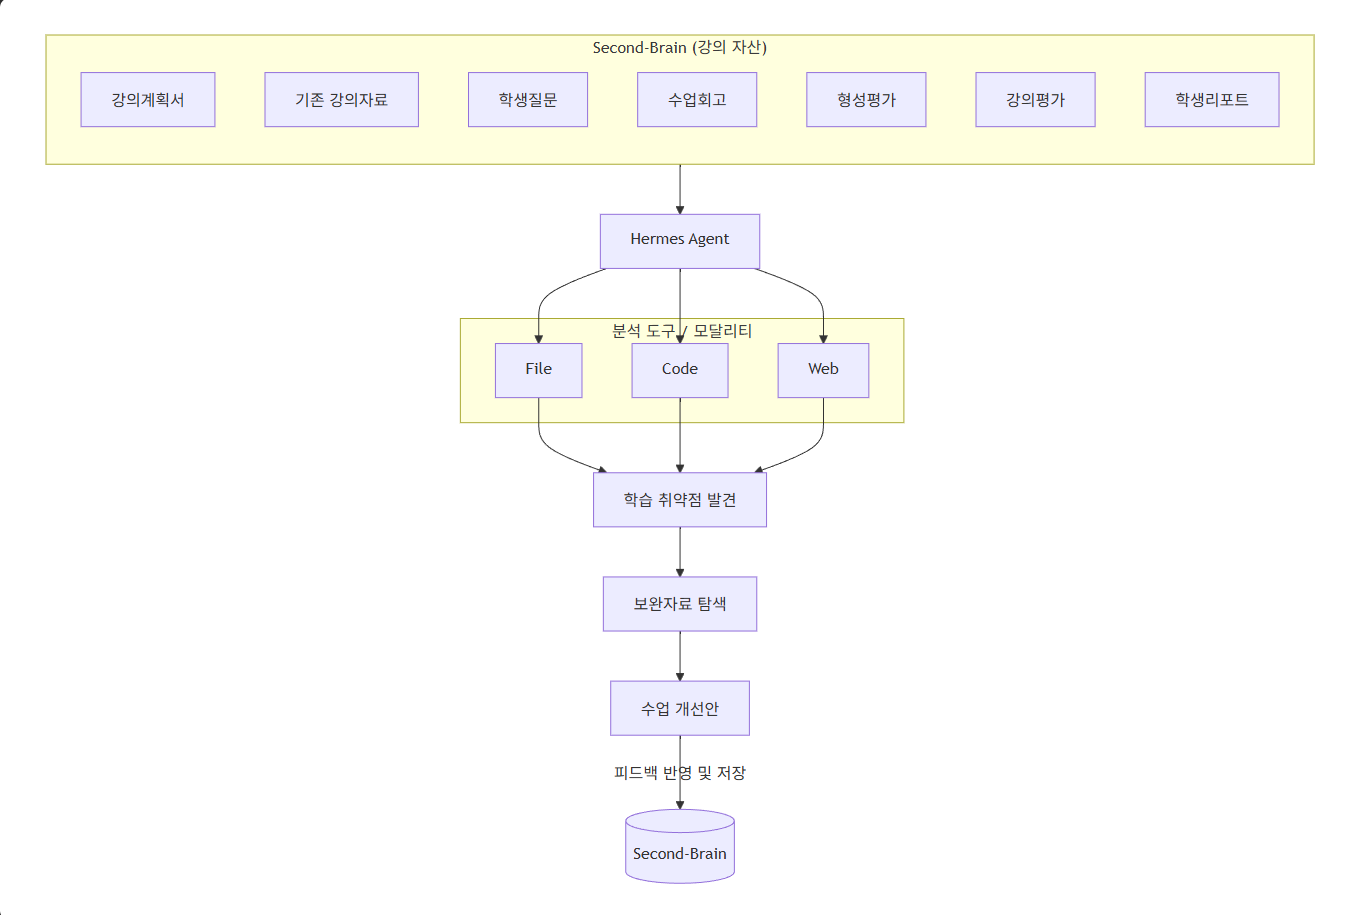
1. Second-Brain을 수업 업무에 활용
1-1. 연구 업무에서 수업 업무로
2장에서는 Hermes가 다음과 같은 자료를 사용함.
- 연구 아이디어
- 연구노트
- 연구지원사업 공고
- Web의 현재 정보
이번 장에서는 중심 자료가 달라짐.
연구 업무
research-notes
      ↓

수업 업무
teaching
Second-Brain/teaching에는 지난 학기의 실제 수업 흐름을 다시 확인할 수 있는 여러 종류의 자료가 저장되어 있음.
teaching/
│
├─ 강의계획서.pdf
├─ 강의자료/
│   ├─ 01주차_생성형 AI와 대학 학습의 변화.pdf
│   ├─ 02주차_질문 설계와 프롬프트.pdf
│   ├─ 03주차_AI 정보의 검증과 출처 확인.pdf
│   └─ ...
│
├─ 학생질문/
│   ├─ 01주차_학생질문.md
│   ├─ 02주차_학생질문.md
│   └─ ...
│
├─ 수업회고/
│   ├─ 03주차_수업회고.md
│   ├─ 07주차_수업회고.md
│   ├─ 11주차_수업회고.md
│   └─ 14주차_수업회고.md
│
├─ 형성평가_문항별결과.xlsx
├─ 강의평가.xlsx
├─ 성적.xlsx
├─ 채점기준.pdf
└─ 학생리포트/
    ├─ 2026101_김민서_리포트.pdf
    ├─ 2026102_이준호_리포트.pdf
    └─ ...
각 파일은 서로 다른 정보를 담고 있음.
| 자료 | 확인할 수 있는 내용 |
|---|---|
| 강의계획서 | 수업의 전체 목표와 주차별 계획 |
| 강의자료 | 실제로 어떤 내용을 가르쳤는지 |
| 학생질문 | 학생이 어디에서 막혔는지 |
| 수업회고 | 교수자가 수업 후 무엇을 느꼈는지 |
| 형성평가 | 특정 학습요소를 실제로 수행했는지 |
| 강의평가 | 학생이 어떤 부분을 어렵게 느꼈는지 |
| 학생리포트 | 학기 후반에도 같은 문제가 남아 있는지 |
하나의 자료만 확인하면 학생들의 학습상황을 일부만 볼 수 있음.
학생 질문만 보면
→ 학생이 무엇을 물었는지 알 수 있음

형성평가만 보면
→ 무엇을 수행하지 못했는지 알 수 있음

수업회고만 보면
→ 교수자가 무엇을 관찰했는지 알 수 있음

여러 자료를 함께 보면
→ 같은 문제가 반복되는지 확인 가능
1-2. 일반적인 LLM 사용과 Second-Brain 기반 Agent
ChatGPT나 Claude와 같은 일반적인 Cloud LLM도 PDF와 Excel 파일을 업로드하여 분석할 수 있음.
따라서 파일을 분석할 수 있다는 것 자체가 Hermes만의 특징은 아님.
이번 과정에서 중요한 차이는 AI 모델 자체보다 작업환경에 있음.
일반적인 파일 업로드 방식
사용자
  ↓
필요한 파일을 찾음
  ↓
파일 선택
  ↓
채팅창에 업로드
  ↓
분석 요청
사용자가 먼저 다음을 판단해야 함.
- 어떤 파일이 필요한지
- 파일이 어디에 있는지
- 몇 개를 업로드해야 하는지
- 다른 관련 자료가 더 있는지
Second-Brain 기반 Agent
사용자
  ↓
업무 목표 제시
  ↓
Hermes
  ↓
Second-Brain 탐색
  ↓
필요한 자료 선택
  ↓
분석
예:
👤 일반적인 요청
지난 학기 수업에서 학생들이 가장 어려워했던 부분을 찾아줘.
이 요청에는 파일명이 없음.
Hermes가 작업을 수행하려면 스스로 다음 자료를 찾아야 함.
강의계획서.pdf학생질문/수업회고/형성평가_문항별결과.xlsx강의평가.xlsx- 필요한 경우
학생리포트/
즉, 이번 장의 핵심은 AI에게 파일을 주는 것이 아니라
AI에게 업무를 주고, 필요한 파일은 AI가 찾도록 하는 것임.
핵심
Hermes를 사용하는 이유는 LLM의 답변 능력이 특별히 다르기 때문이 아님.
교수자의 로컬 지식공간을 하나의 지속적인 작업환경으로 사용하고, 목표에 따라 필요한 자료와 Tool을 함께 사용할 수 있다는 점이 핵심임.
1-3. 이번 장의 시작 질문
지난 학기의 전체 자료를 바탕으로 수업 개선이 필요한 지점을 먼저 탐색함.
👤 Hermes에 입력
Second-Brain에 있는 지난 학기AI와 교육혁신수업자료를 살펴보고
학생들이 반복적으로 어려워한 학습내용을 찾아줘.강의계획서, 학생질문, 수업회고, 형성평가, 강의평가 등
필요한 자료는 네가 직접 찾아서 사용해줘.아직 Web 검색은 하지 말고
내Second-Brain안의 자료만 사용해줘.어떤 파일을 근거로 판단했는지 함께 알려줘.
수행 과정 확인
Hermes가 처음부터 모든 파일을 읽는 것이 아니라 필요한 자료를 탐색하는지 확인함.
업무 목표
"반복되는 학습 취약점 및 오개념 도출"
       │
       ▼
[1단계] 정량 데이터 1차 스크리닝 (강의평가·성적 분석)
       - 난이도 체감 주차 식별 (3주차: 출처 검증, 11주차: 데이터 해석)
       │
       ▼
[2단계] 정량 평가 상세 검증 (형성평가 문항별 통계 계산)
       - 취약 영역 수치 확인 (교차검증 62.5%, 출처 존재 검증 70.8%)
       │
       ▼
[3단계] 정성 데이터 심층 분석 (주차별 학생 질문 탐색)
       - 1~15주차 질문 파일(teaching/학생질문/*.md) 텍스트 마이닝
       - 반복되는 질문 패턴 및 주요 키워드 추출
       │
       ▼
[4단계] 종합 교차 분석 및 오개념 특정
       - '링크 존재 = 검증 완료'라는 오개념 및 AI 인용 맹신 문제 도출
       │
       ▼
최종 도출
"3주차: AI 생성 정보의 교차 검증 및 원문 대조 취약"
🤖 Hermes 응답
Second-Brain 내부의 지난 학기 《AI와 교육혁신》 강좌 관련 자료(형성평가, 강의평가, 1~15주차 학생 질문, 수업회고, 학생 면담, 수신 이메일 등)를 교차 분석한 결과, 학생들이 반복적으로 가장 큰 어려움을 겪은 학습내용은 크게 3가지로 도출되었습니다.
1. 가장 두드러진 어려움: AI 정보의 출처 검증과 교차검증 (3주차 중심)
학생들은 프롬프트 작성이나 AI 기본 원리 이해에는 큰 어려움이 없었으나, AI가 제시한 출처가 실재하는지, 원문과 내용이 일치하는지, 복수의 독립된 출처로 교차검증하는 단계에서 가장 심각한 어려움과 혼란을 겪었습니다.
세부적인 어려움 양상
- 외형적 단서(링크)에 대한 맹신과 원문 대조 부족:
- "AI 답변에 링크나 논문 제목이 있으면 검증된 것으로 착각"하는 경향.
- 출처 링크가 걸려 있어도 실제 해당 원문 내용과 맞지 않거나, 논문 제목은 존재하나 저자가 다른 '부분적 환각'을 판별하는 데 어려움을 겪음.
- 교차검증의 기준과 범위 모호성:
- "자료를 몇 개까지 교차검증해야 충분한가?", "서로 다른 언론사 기사 2개가 동일한 보도자료를 인용한 경우도 교차검증으로 볼 수 있는가?" 등 검증 기준의 모호함을 지속적으로 호소함.
- 실습 시간 부족 및 확인 절차의 피로도:
- 과제나 리포트 작성 시 매번 원문 검색 및 대조를 직접 수행하는 데 많은 시간이 소요되어 실습 및 구체적 가이드라인을 요구함.
📌 근거 파일 및 실증 데이터
teaching/형성평가_문항별결과.xlsx(정량 데이터)- 수강생 24명 대상 8개 평가 항목 중 **'교차검증' 통과율이 62.5%(15/24명)**로 전체 최저.
- **'출처존재확인' 통과율 역시 70.8%(17/24명)**로 두 번째로 낮음. (반면 '프롬프트조건' 100%, 'AI특징' 95.8%, '요약검토' 91.7%는 매우 높음)
teaching/강의평가.xlsx(수강생 20명 응답)- **"가장 어려웠던 주차"로 3주차를 지목한 학생이 7명(35%)**으로 단일 주차 중 압도적 1위.
- 서술형 의견:
- R01: "출처 검증이 가장 어려웠다. 설명보다 직접 검색해서 확인하는 시간이 더 있었으면 좋겠다."
- R02: "AI가 준 링크가 실제 내용과 맞는지 확인하는 과정이 아직 헷갈린다."
- R07: "교차검증을 몇 개 자료까지 해야 하는지 감이 잘 안 왔다."
- R16: "원문 확인과 교차검증의 차이를 실습으로 한 번 더 하면 좋겠다."
teaching/학생질문/03주차_학생질문.md(단일 주차 최다 질문 8건 집중)- "AI가 논문 제목과 저자를 알려주면 진짜 논문인지 어떻게 확인해요?"
- "링크까지 주면 그건 믿어도 되는 거 아닌가요?"
- "AI가 인용한 문장이 원문에 실제로 있는지 빨리 확인하는 방법이 있나요?"
- "논문 제목은 있는데 저자가 다르면 어떻게 해야 해요?"
teaching/수업회고/03주차_수업회고.md및07주차_수업회고.md- 03주차: "학생들이 출처의 존재 여부는 확인하지만 원문 내용까지 대조하는 경우는 많지 않았음 / 출처 두 개를 비교하도록 했을 때 판단 근거 설명에 시간이 오래 걸림"
- 07주차: "일부 학생은 AI 답변에 링크가 포함되어 있으면 검증이 끝난 것으로 생각함"
research/interviews/학생면담_요약.md- 학생A: "AI가 틀릴 수 있다는 건 알지만 과제할 때 매번 원문까지 확인하는 건 생각보다 어렵다. 어디까지 해야 충분한지 잘 모르겠다."
workspace_seed/gmail/메일시드.md- G03 (학생 S18): "과제에서 AI가 제시한 논문을 확인했는데 검색되지 않는 경우 결과에서 제외해야 하는지... 출처 검증 과정을 어느 정도까지 기록해야 하나요?"
- G11 (학생 S07): "서로 다른 기사 두 개가 같은 보도자료를 인용하면 교차검증으로 볼 수 있는지 설명 부탁드립니다."
2. 두 번째 어려움: 데이터 해석과 통계적 추론 (11주차)
표나 그래프 자체를 읽는 것보다, 통계 수치를 비판적으로 해석하고 상관관계와 인과관계를 구분하여 수업 개선안을 도출하는 논리적 연결을 어려워했습니다.
세부적인 어려움 양상
- 단순 수치나 평균값만 보고 성급하게 전체 결론을 단정 짓는 경향.
- 출석률과 성적의 상관관계를 단순 인과관계로 오인하는 문제.
- 단일 데이터만 보고 결론을 내리며, 복합 데이터(질문 기록 + 형성평가)를 통합 해석하는 데 어려움을 겪음.
📌 근거 파일
teaching/강의평가.xlsx- R05: "평균과 상관관계 설명이 조금 빨랐다. 예제가 하나 더 있었으면 좋겠다."
- R12: "데이터 해석 부분은 조금 어려웠다." (어려웠던 주차로 11주차 지목)
teaching/학생질문/11주차_학생질문.md- "평균이 높으면 대부분 잘한 거라고 봐도 되나요?"
- "출석이 낮아서 성적이 낮다고 말해도 되나요?"
- "그래프가 있으면 통계가 더 정확해지는 건 아니죠?"
teaching/수업회고/11주차_수업회고.md- "표와 수치 해석 자체는 대체로 수행함 / 분석 결과를 근거로 수업 개선안을 제시하는 단계에서 어려움이 나타남 / 몇몇 학생이 데이터 한 종류만 보고 결론을 내리는 경향"
research/interviews/학생면담_요약.md- 학생E: "데이터 해석 주차는 숫자보다 설명이 어려웠다. 상관관계와 원인을 자꾸 헷갈린다."
3. 세 번째 어려움: AI 활용 과정 기록과 저자성 판단 기준 (6주차, 12주차, 14주차)
AI를 과제에 활용할 때 **"어디까지 밝혀야 하는가(기록 범위)", "AI 산출물을 얼마나 수정해야 나의 글(저자성)인가"**에 대한 평가 기준의 모호성을 지속적으로 질의했습니다.
세부적인 어려움 양상
- 최종 결과물의 텍스트 완성도는 높으나, 본인이 AI를 어떻게 활용했고 어떤 수정을 거쳤는지 기록하는 방식의 격차가 큼.
- 프롬프트 로그 전체를 제출해야 하는지, 수정 과정만 서술하면 되는지 기준을 혼동.
📌 근거 파일
teaching/학생질문/06주차_학생질문.md&12주차_학생질문.md- 06주차: "AI가 쓴 문장을 제가 많이 고치면 제 글인가요?", "AI 사용 기록은 어느 정도까지 적어야 해요?"
- 12주차: "결과가 같아도 수정 과정이 다르면 점수가 달라질 수 있나요?", "프롬프트도 평가 대상에 넣어야 하나요?"
teaching/수업회고/14주차_수업회고.md- "발표 결과물의 완성도는 높았으나 제작 과정 기록의 편차가 큼 / AI를 어떻게 사용했고 무엇을 직접 확인했는지 설명이 부족한 팀이 있었음"
research/interviews/학생면담_요약.md- 학생F: "AI 사용을 금지하는 것보다 어떻게 썼는지 보여주는 방식이 현실적인 것 같다."
knowledge/research-notes/2026-04-10_과정데이터.md- "프롬프트 로그 전체를 받는 건 과한 것 같다. 핵심 수정 전/후와 수정 이유 정도면 충분하지 않을까."
4. 종합 결론 및 수업 개선 시사점
| 순위 | 반복된 어려움 (학습내용) | 핵심 지표 / 취약 영역 | 수업 개선 우선순위 과제 |
|---|---|---|---|
| 1위 | 출처 검증 및 교차검증 (3주차) | 형성평가 교차검증 통과율 62.5% \ 강의평가 난이도 1위 (35%) \ 3주차 학생 질문 8건 집중 | 4단계 검증 루브릭(존재→원문대조→교차검증→판단설명) 실습 시간 대폭 확대 |
| 2위 | 데이터 해석 및 상관/인과 추론 (11주차) | 강의평가 서술형 피드백 지목 \ 단일 데이터 편향 해석 경향 | 형성평가 결과와 질문 데이터를 교차 해석하는 실습 예제 보강 |
| 3위 | 과정 중심 기록 및 저자성 기준 (6, 12, 14주차) | 팀별/개인별 과정 기록 편차 심화 \ 기록 범위 및 저자성 문의 다수 | 경량화된 과정 기록 서식(수정 전/후 + 수정 이유) 표준화 제공 |
이 분석 결과는 앞서 살펴본 2026 교수학습혁신 지원사업의 '과정 중심 평가 개선' 및 '학습데이터 기반 수업개선' 연구계획의 핵심 근거자료로 즉시 활용할 수 있습니다.
결과 확인
- 사용자가 파일을 하나씩 첨부하지 않음
-
teaching폴더를 직접 탐색함 - 학생질문과 수업회고가 함께 사용됨
- Excel 데이터의 존재를 확인함
- 판단 근거가 된 파일명이 표시됨
- Web 자료를 아직 사용하지 않음
이번 시작 질문만으로도 몇 가지 문제 후보가 나타날 수 있음.
예:
- 출처 존재 여부와 원문 내용 확인의 차이
- 교차검증 방법
- 평균과 인과관계 해석
- AI 활용 과정의 평가
이 단계에서는 바로 수업안을 수정하지 않음.
정말 반복되는 문제인지 추가 자료를 통해 확인함.
2. 학생 반응에서 학습문제 찾기
2-1. 학생질문 탐색
학생들이 수업에서 남긴 질문은 단순한 질문 목록이 아님.
학생이 어떤 개념에서 멈췄는지를 보여주는 학습 흔적으로 사용할 수 있음.
teaching/학생질문에는 1주차부터 15주차까지 학생 질문이 저장되어 있음.
특정 주차를 먼저 찾지 않기
사용자가 먼저 "3주차가 문제였을 것"이라고 정하지 않음.
Agent가 전체 학생질문을 살펴보고 반복되는 주제를 찾도록 요청함.
👤 Hermes에 입력
teaching/학생질문폴더의 질문들을 전체적으로 살펴보고
여러 주차에서 반복해서 등장하는 어려움이나 질문 유형을 찾아줘.단순히 단어가 같은 질문만 묶지 말고
의미가 비슷한 질문도 함께 살펴봐.반복되는 주제마다 근거가 된 파일과 질문 예를 알려줘.
확인할 수 있는 흐름
예를 들어 출처 검증과 관련된 질문은 한 주차에서 끝나지 않음.
03주차_학생질문.md
- AI가 알려준 논문이 실제 존재하는지 확인하는 방법
- 링크가 있으면 믿어도 되는지
- 검색 결과가 다를 때 어떤 자료를 믿어야 하는지
- 교차검증을 몇 개의 자료로 해야 하는지
- AI가 인용한 문장이 실제 원문에 있는지 확인하는 방법
05주차_학생질문.md
- AI가 요약한 논문을 그대로 인용해도 되는지
- 페이지 번호까지 AI가 제시하면 다시 확인해야 하는지
- 요약에서 중요한 조건이 빠졌는지 확인하는 방법
07주차_학생질문.md
- AI 답변의 오류를 찾는 방법
- 근거가 맞지만 결론이 이상한 경우의 판단
같은 문제가 표현만 바뀌어 다시 나타날 수 있음.
출처가 있는가?
      ↓
원문이 실제로 존재하는가?
      ↓
AI 설명과 원문이 일치하는가?
      ↓
다른 자료에서도 확인되는가?
      ↓
최종 판단을 설명할 수 있는가?
🤖 Hermes 응답
teaching/학생질문 폴더 내 15개 주차의 모든 질문(총 45개)을 의미론적 맥락과 내재된 학습 고민을 바탕으로 분석한 결과, 여러 주차에 걸쳐 반복적으로 등장하는 핵심 어려움과 질문 유형은 다음 5가지로 집약됩니다.
단순히 동일한 어휘를 쓴 것이 아니라, 학습 단계가 진행되면서 동일한 근본적 고민이 구체화되거나 형태를 바꾸어 재등장하는 구조를 보이고 있습니다.
1. "어디까지 확인해야 충분한가?" — 검증 범위와 피로도에 대한 고민
학생들은 AI가 그럴듯한 근거(링크, 인용, 페이지 번호)를 제시할 때 이를 원문과 대조하는 절차의 기준과 현실적인 검증 한계선에 대해 여러 차례 반복하여 질문했습니다.
- 반복된 핵심 고민: 링크나 출처가 있으면 믿어도 되는지, 다수의 출처를 일일이 원문 대조해야 하는지, 어디까지 검증해야 성실한 확인으로 인정받는지에 대한 기준 모호성.
- 근거 파일 및 질문 예시:
03주차_학생질문.md:- "링크까지 주면 그건 믿어도 되는 거 아닌가요?"
- "AI 답변에 출처가 5개나 있으면 전부 확인해야 하나요?"
- "AI가 인용한 문장이 원문에 실제로 있는지 빨리 확인하는 방법이 있나요?"
04주차_학생질문.md:- "검색 결과가 너무 많을 때 먼저 볼 자료를 어떻게 고르나요?"
05주차_학생질문.md:- "페이지 번호까지 AI가 알려주면 확인해야 하나요?"
- "AI가 요약한 논문을 그대로 인용하면 안 되나요?"
07주차_학생질문.md:- "오류가 하나도 없어 보이면 뭘 확인해야 하나요?"
2. "얼마나 고쳐야 내 글인가?" — 저자성(Ownership)과 과정 평가 기준
초반에는 "AI 사용이 부정행위인가"라는 단순한 두려움에서 출발하여, 중반부에는 "내 작업의 지분(저자성) 인정 기준", 후반부에는 **"수정 과정이 어떻게 평가에 반영되는가"**로 질문이 심화되며 학기 내내 반복되었습니다.
- 반복된 핵심 고민: AI의 도움을 받은 글에서 인간의 기여도 인정 기준, 아이디어 단계 활용 표기 의무, 프롬프트나 수정 로그가 점수화되는 방식.
- 근거 파일 및 질문 예시:
01주차_학생질문.md:- "과제에서 AI를 쓰면 무조건 부정행위인가요?"
06주차_학생질문.md:- "AI가 쓴 문장을 제가 많이 고치면 제 글인가요?"
- "AI 사용 기록은 어느 정도까지 적어야 해요?"
- "아이디어만 AI에게 받은 것도 밝혀야 하나요?"
09주차_학생질문.md:- "AI가 만든 수업안을 교수님이 거의 다 고치면 AI를 쓰는 의미가 있나요?"
12주차_학생질문.md:- "AI를 썼는지 안 썼는지보다 뭘 평가해야 하나요?"
- "결과가 같아도 수정 과정이 다르면 점수가 달라질 수 있나요?"
- "프롬프트도 평가 대상에 넣어야 하나요?"
3. "AI에게 이것까지 맡겨도 되는가?" — 인간의 최종 판단과 위임 경계
과제를 수행하거나 활동을 할 때, 비평, 피드백, 목표 설정과 같은 고차원적 사고 활동까지 AI에게 재의존해도 되는지에 대한 경계선 질문이 반복되었습니다.
- 반복된 핵심 고민: 오류 검증 자체를 AI에게 시켜도 되는지, 피드백이나 핵심 목표 설정까지 AI에 일임했을 때의 타당성.
- 근거 파일 및 질문 예시:
07주차_학생질문.md:- "틀린 답을 찾는 것도 AI에게 시켜도 되나요?"
09주차_학생질문.md:- "학습목표도 AI에게 만들게 해도 되나요?"
14주차_학생질문.md:- "발표 피드백도 AI가 대신해도 되나요?"
4. "상충하는 정보 중 무엇을 신뢰해야 하는가?" — 출처 간 신뢰도와 인과 추론
단순 참/거짓 판별을 넘어, 서로 다른 두 출처의 내용이 부딪히거나, 겉보기 형식(통계 그래프, 기관 권위)과 실질적 사실이 충돌할 때 판단하는 기준을 어려워했습니다.
- 반복된 핵심 고민: 권위 있는 기관 자료와 최신 웹 자료의 충돌, 다수의 의견(좋아요/인기)과 본질적 중요도의 괴리, 통계 수치와 인과관계의 혼동.
- 근거 파일 및 질문 예시:
03주차_학생질문.md:- "검색 결과 두 개가 서로 다르면 뭘 믿어야 해요?"
- "정부기관 자료와 블로그 내용이 다르면 무조건 기관 자료가 맞나요?"
10주차_학생질문.md:- "좋아요가 많은 질문과 중요한 질문은 다를 수도 있지 않나요?"
11주차_학생질문.md:- "그래프가 있으면 통계가 더 정확해지는 건 아니죠?"
- "출석이 낮아서 성적이 낮다고 말해도 되나요?" (상관 vs 인과 혼동)
5. "내 데이터/타인 데이터를 AI에 넣어도 안전한가?" — 프라이버시와 윤리적 책임
멀티모달 이미지 처리부터 리포트 채점, 계정 보안 등 실제 자료를 AI 모델에 업로드하는 순간 발생하는 개인정보 유출 및 저작권 침해 우려가 중후반부에 지속적으로 표출되었습니다.
- 반복된 핵심 고민: 과제물·이미지 업로드 시 개인 식별 정보 보호, 학교 공식 계정의 안전성 보장 범위.
- 근거 파일 및 질문 예시:
08주차_학생질문.md:- "이미지를 넣을 때 개인정보가 있으면 어떻게 해요?"
13주차_학생질문.md:- "학생 리포트를 AI에 넣으면 개인정보 문제는 없나요?"
- "AI가 만든 이미지의 저작권은 누구에게 있나요?"
- "학교 계정이면 아무 자료나 넣어도 괜찮나요?"
💡 요약 및 종합 시사점
질문들을 관통하는 학생들의 가장 본질적인 결핍은 **"명확한 판단 준거(Criteria)의 부재"**입니다.
- 학생들은 AI 조작법(프롬프트 입력 등)보다 **"어디까지 확인해야 충분한가(검증 루브릭)", "어디까지가 나의 저작물인가(저자성)", "수정 과정 중 무엇을 기록해야 하는가(과정 평가 서식)"**에 대한 구체적인 규칙과 가이드라인을 학기 내내 갈망하고 있었습니다.
- 따라서 차기 학기 수업 개선이나 지원사업 모델에서는 이 5가지 질문 유형에 직접 답을 제공하는 구체적인 '체크리스트'와 '단계별 루브릭'의 제공이 핵심 과제가 됩니다.
결과 확인
- 15개 학생질문 파일을 탐색함
- 서로 다른 주차의 질문이 연결됨
- 단순 키워드가 아니라 의미가 비슷한 질문도 함께 제시됨
- 반복되는 문제의 근거 파일이 표시됨
2-2. 수업회고와 교수자의 기록 확인
학생 질문만으로 수업 전체 상황을 판단하지 않음.
교수자가 수업 직후 남긴 기록도 함께 확인함.
주요 자료:
teaching/수업회고/
    03주차_수업회고.md
    07주차_수업회고.md
    11주차_수업회고.md
    14주차_수업회고.md

knowledge/teaching-notes/
    2026-03-17_3주차_수업후.md
    2026-03-18_어제_질문들.md
    2026-05-12_데이터해석_수업.md
    2026-05-19_평가_수업후.md
    ...
입력
👤 Hermes에 입력
방금 찾은 학생들의 반복적인 어려움이
교수자의 수업회고와 teaching-notes에도 나타나는지 확인해줘.같은 문제를 뒷받침하는 기록과
서로 다른 판단을 보여주는 기록을 구분해서 알려줘.
🤖 Hermes 응답
교수자의 **수업회고(teaching/수업회고/)**와 강의 준비 및 성찰 기록인 **teaching-notes(knowledge/teaching-notes/`)**를 대조 분석한 결과, 학생들의 고민과 교수자의 시각 사이에는 **'정확히 일치하여 문제를 뒷받침하는 기록'**과 **'학생과 교수자 간 인식의 간극 및 관점의 차이를 보여주는 기록'**이 뚜렷하게 나뉘어 나타납니다.
1. 같은 문제를 뒷받침하는 기록 (학생의 어려움 = 교수자의 관찰 일치)
교수자는 수업 현장에서 학생들이 겪는 어려움의 본질을 즉시 포착하고 회고록에 기록해 두었습니다.
① "링크의 존재"와 "실제 내용 일치"의 혼동 (3주차·5주차)
- 학생의 어려움: AI 답변에 링크나 출처가 표기되어 있으면 사실 확인이 끝난 것으로 오인함. (
03주차_학생질문.md: "링크까지 주면 그건 믿어도 되는 거 아닌가요?",05주차_학생질문.md: "AI가 요약한 논문을 그대로 인용하면 안 되나요?") - 교수자의 동일 인식:
knowledge/teaching-notes/2026-03-18_어제_질문들.md: "링크가 있으면 믿어도 되냐는 질문이 여러 번 나옴. '링크 존재'와 '내용 일치'를 학생들이 별개로 생각하지 않는 것 같다."teaching/수업회고/03주차_수업회고.md: "학생들이 출처의 존재 여부는 확인하지만 원문 내용까지 대조하는 경우는 많지 않았음."knowledge/teaching-notes/2026-03-31_요약_인용.md: "AI 요약을 그대로 인용하려는 학생이 있었다. 원문을 안 보고도 인용할 수 있다고 생각하는 건가. 3주차와 결국 같은 문제다."
② 출처 확인 실습 시간 부족과 설명 과다 (3주차)
- 학생의 어려움: 출처 검증과 논문 검색을 직접 해보는 실습 시간이 턱없이 부족했음을 토로함. (
teaching/강의평가.xlsxR01, R10: "설명보다 직접 검색해서 확인하는 시간이 더 있었으면 좋겠다") - 교수자의 동일 인식:
knowledge/teaching-notes/2026-03-17_3주차_수업후.md: "환각 사례 설명에 시간을 너무 많이 썼다. 정작 학생들이 직접 논문 제목 검색하고 원문 비교하는 시간이 부족했음. 다음에는 설명 20분 줄이고 실제 확인부터 시켜보는 게 낫겠다."
③ 상관관계와 인과관계의 혼동 (11주차 데이터 해석)
- 학생의 어려움: 두 수치가 같이 움직일 때 원인과 결과를 혼동함. (
11주차_학생질문.md: "출석이 낮아서 성적이 낮다고 말해도 되나요?") - 교수자의 동일 인식:
knowledge/teaching-notes/2026-05-12_데이터해석_수업.md: "평균과 인과관계 설명에서 시간이 오래 걸렸다. 표 읽는 건 괜찮은데 '같이 움직이면 원인'이라고 생각하는 학생이 아직 있음."teaching/수업회고/11주차_수업회고.md: "몇몇 학생이 데이터 한 종류만 보고 결론을 내리는 경향을 보였음."
④ 수업 중 질문 표출의 심리적 장벽과 익명 창구 필요성 (10주차)
- 학생의 어려움: 비슷한 질문일까 봐, 혹은 수업 흐름을 끊을까 봐 질문하지 못함. (
research/interviews/학생면담_요약.md학생D,10주차_학생질문.md) - 교수자의 동일 인식:
knowledge/teaching-notes/2026-05-06_질문_놓친것.md: "어제 수업 끝나고 학생 둘이 와서 질문했다. 수업 중에는 질문 못 했다고 함. 실시간 익명 질문 창이 있으면 나을까."knowledge/teaching-notes/2026-05-05_질문_수집.md: "포스트잇으로 받았는데 비슷한 질문이 너무 많다... 익명으로 받고 비슷한 것끼리 자동으로 묶어주면 좋을 텐데."
⑤ 학생 과제물의 AI 업로드에 따른 개인정보 유출 우려 (13주차)
- 학생의 어려움: 내 과제나 리포트 파일이 AI 학습에 쓰이거나 유출되는지 걱정. (
13주차_학생질문.md: "학생 리포트를 AI에 넣으면 개인정보 문제는 없나요?") - 교수자의 동일 인식:
knowledge/teaching-notes/2026-05-26_윤리_수업.md: "실제 리포트 파일을 외부 AI에 넣는 상황을 예로 드니 이해가 빠름."knowledge/teaching-notes/2026-05-27_개인정보_체크리스트.md: "학생자료 AI 활용 전에 이름/학번/연락처가 들어 있는지 먼저 확인하는 체크리스트를 만들어둘까."
2. 서로 다른 판단 및 관점의 간극을 보여주는 기록
학생들이 느끼는 고민의 방향과 교수자가 수업 설계자로서 내린 판단 사이에는 뚜렷한 인식의 간극이 존재했습니다.
① 좋은 프롬프트에 대한 관점: "길이/역할" vs "조건의 명확성"
- 학생들의 시각: 프롬프트는 최대한 길게 서술하거나 페르소나(역할)를 많이 부여해야 좋은 결과가 나온다고 여김. (
02주차_학생질문.md: "프롬프트는 길게 쓰는 게 좋은가요?", "역할을 정해주면 왜 답이 달라지나요?") - 교수자의 판단:
knowledge/teaching-notes/2026-03-10_프롬프트_실습.md: "몇 명은 좋은 프롬프트를 '길게 쓰는 것'으로 받아들인 듯. 다음에는 같은 내용인데 짧고 명확한 예를 하나 보여주자."
(학생들은 '양과 기법'에 집착했으나, 교수자는 '간결성과 명확한 제약 조건'이 본질이라고 판단함)
② 평가의 초점: "AI 사용 적발/부정행위" vs "과정 중심 수정 역량"
- 학생들의 시각: AI를 사용하는 것 자체가 감점 요인인지, 어디까지 허용되는지 '적발과 규제'의 관점에서 불안해함. (
01주차_학생질문.md: "AI를 쓰면 무조건 부정행위인가요?",12주차_학생질문.md: "AI를 썼는지 안 썼는지보다 뭘 평가해야 하나요?") - 교수자의 판단:
knowledge/teaching-notes/2026-05-19_평가_수업후.md: "AI를 썼는지 잡아내는 것보다 결과의 문제를 찾아 고치게 하는 게 교육적으로 더 낫다는 생각이 점점 강해진다."knowledge/teaching-notes/2026-04-08_중간활동_채점.md: "학생이 틀린 부분을 정확히 찾았어도 이유 설명이 약한 경우가 있다. '정답 찾기'와 '판단 근거'는 따로 봐야겠다."
(학생은 '사용 여부'를 걱정했으나, 교수자는 '비판적 수정 과정과 판단 근거 설명'이 핵심 평가 지표여야 한다고 판단함)
③ AI 생성 결과물에 대한 비판적 거리: "쉽게 만족" vs "구조적 결함 간파"
- 학생들의 태도: AI가 작성해 준 결과물(수업안, 과제 초안)이 문맥상 매끄러우면 쉽게 완성도 높은 안으로 수용함. (
07주차_학생질문.md: "오류가 하나도 없어 보이면 뭘 확인해야 하나요?") - 교수자의 판단:
knowledge/teaching-notes/2026-04-28_수업설계_활동.md: "AI가 만든 수업안을 학생들이 너무 쉽게 '괜찮다'고 평가한다. 학습목표와 활동이 정말 맞는지 기준을 먼저 줘야 했다."
(학생은 표면적인 유창함에 속았으나, 교수자는 교육 목표와 활동 간의 '정합성 부재'를 포착하고 평가 기준(루브릭)을 먼저 제시해야 한다고 판단함)
④ 과정 데이터 수집의 범위: "전수 기록 제출" vs "핵심 수정 사유만 추출"
- 학생들의 혼란: AI 활용 과정을 입증하기 위해 모든 프롬프트 대화 로그를 제출해야 하는지 부담스러워함. (
06주차_학생질문.md: "AI 사용 기록은 어느 정도까지 적어야 해요?") - 교수자의 판단:
knowledge/research-notes/2026-04-10_과정데이터.md: "프롬프트 로그 전체를 받는 건 과한 것 같다. 핵심 수정 전/후와 수정 이유 정도면 충분하지 않을까."
(과도한 로그 수집은 학생의 작성 피로도를 높이고 교수자의 채점 부담을 가중시키므로, '수정 전/후 + 수정 이유'의 경량화 서식이 적합하다고 판단함)
💡 결론 및 다음 학기 시사점
교수자의 메모는 학생들의 어려움을 단순히 인지하는 것에 그치지 않고, **"학생들의 막연한 불안(적발 공포, 피로도)을 '명문화된 루브릭'과 '경량화된 과정 서식'으로 해소해 주어야 한다"**는 구체적인 해결책으로 수렴하고 있음을 확인할 수 있습니다.
학생질문과 교수자의 수업회고가 같은 방향을 가리키는지 확인함.
학생 질문
"링크가 있으면 믿어도 되나요?"
          +
교수자 회고
"링크가 있으면 검증이 끝난 것으로 생각함"
          ↓
같은 학습문제의 가능성 증가
아직 결론 내리지 않기
정성자료에서 같은 문제가 반복된다고 해서 곧바로 전체 학생의 취약점이라고 확정하지 않음.
다음 단계에서 정량 데이터를 확인함.
3. Tool / Code를 이용한 학습데이터 분석
3-1. LLM이 읽는 것과 Code가 계산하는 것
학생질문과 수업회고는 문장의 의미를 읽고 해석해야 함.
이러한 작업에는 LLM이 적합함.
반면 다음과 같은 질문은 정확한 계산이 필요함.
- 24명 중 몇 명이 교차검증을 수행했는가?
- 각 평가항목의 수행률은 몇 %인가?
- 어느 주차의 평균 점수가 가장 낮은가?
- 강의평가에서 가장 어렵다고 응답한 주차는 어디인가?
- 평가항목별 평균을 낮은 순서로 정렬하면 어떻게 되는가?
LLM이 표를 읽고 눈대중으로 계산하도록 하는 것보다 계산 도구를 사용하는 것이 적합함.
역할의 차이
| 작업 | 적합한 방식 |
|---|---|
| 학생 질문의 의미 해석 | LLM |
| 수업회고의 의미 파악 | LLM |
| 24명의 0/1 값 합계 | Code |
| 비율 계산 | Code |
| 평균·분포 계산 | Code |
| 반복되는 오개념 판단 | LLM |
| 최신 보완자료 검색 | Web |
LLM
→ 의미를 이해하고 판단

Code
→ 정확하게 계산
이번 장에서 Tool / Code를 추가하는 이유는 코딩을 하기 위해서가 아니라 계산이 필요한 일을 계산 도구에게 맡기기 위해서임.
3-2. Hermes의 Code와 데이터 처리
현재 Hermes는 파일을 읽는 기능과 별도로 Python 기반 Code Execution, Terminal 등의 Tool을 제공함.
또한 .xlsx 파일은 Document Extraction을 통해 내용을 읽을 수 있으며, 현재 공식 배포에는 Excel 작업을 위한 xlsx Skill도 기본 포함되어 있음.
실제 작업에서 Agent가 어떤 Tool을 선택하는지는 요청과 현재 환경에 따라 달라질 수 있음.
예:
.xlsx 구조 확인
     ↓
read_file / xlsx 관련 기능

정확한 집계·반복 계산
     ↓
execute_code / terminal / xlsx 관련 기능
교육생이 Tool의 내부 호출 순서를 직접 설계하는 것이 목표가 아님.
Tool 상태 확인
- Hermes Desktop에서 현재 Session 선택
- [Capabilities]에서 사용 가능한 Tool 확인
- File 관련 Tool 활성 상태 확인
- Code Execution 또는 현재 버전의 Code 관련 Tool 확인
- Terminal 관련 Tool 확인
핵심 원칙
사용자는 다음과 같이 업무의 요구조건만 제시함.
정확한 계산이 필요한 부분은 추측하지 말고 계산 도구를 사용해줘.
Agent가 실제 Tool을 선택함.
3-3. 형성평가 데이터 구조 확인
이번 실습에서 사용할 파일:
teaching/형성평가_문항별결과.xlsx
먼저 계산하지 않고 데이터 구조부터 확인함.
👤 Hermes에 입력
teaching/형성평가_문항별결과.xlsx파일을 찾아서
어떤 데이터가 들어 있는지 먼저 확인해줘.아직 학습결과를 해석하지 말고
학생 수, 평가항목, 값이 무엇을 의미하는지 구조만 설명해줘.
🤖 Hermes 응답
teaching/형성평가_문항별결과.xlsx 파일의 데이터 구조는 다음과 같습니다.
1. 기본 구성
- 시트명:
문항별결과(단일 시트) - 전체 학생 수: 총 24명 (학번:
2026101~2026124)
2. 열(Column) 구성 및 평가항목
데이터는 학생 식별 정보 2개 열과 평가항목 8개 열로 이루어져 있습니다.
- 식별 정보 (2개 열):
학번: 7자리 학생 고유 번호이름: 학생 성명
- 평가항목 (8개 열):
AI특징프롬프트조건출처존재확인원문일치확인교차검증최종판단설명요약검토과정기록
3. 데이터 값(Value)의 의미
- 각 평가항목 셀에는
1또는 **0**의 이진(Binary) 정수 값이 기록되어 있습니다.1: 해당 주차별 형성평가 문항/평가 기준을 **달성(통과/정답)**함0: 해당 주차별 형성평가 문항/평가 기준을 **미달성(미통과/오답)**함
결과 확인
- 24명의 데이터가 확인됨
- 8개 평가항목이 확인됨
- 0과 1의 의미가 확인됨
- 아직 임의의 해석이나 결론을 만들지 않음
3-4. Code를 이용한 항목별 수행률 계산
이번에는 정확한 계산을 요청함.
👤 Hermes에 입력
방금 확인한
형성평가_문항별결과.xlsx를 분석해줘.각 평가항목에 대해 다음을 계산해줘.
1을 받은 학생 수- 전체 24명 중 수행률(%)
- 수행률이 낮은 순서
계산이 필요한 부분은 LLM이 눈으로 추정하지 말고
Code 또는 적절한 계산 Tool을 사용해줘.계산 결과와 해석은 구분해서 보여줘.
계산할 때 사용한 Python 코드 전문과, 그 코드를 실행해서 나온 **터미널 출력 원문(Raw Stdout)**을 답변에 코드 블록으로 그대로 포함해줘.
🤖 Hermes 응답
teaching/형성평가_문항별결과.xlsx 파일의 24명 데이터를 분석한 Python 코드 전문, 실제 실행된 터미널 출력 원문(Raw Stdout), 그리고 계산 결과와 해석입니다.
1. 실행한 Python 코드 전문
import xml.etree.ElementTree as ET
import zipfile

file_path = (
    r"C:\Users\oralc\Downloads\Second-Brain\teaching\형성평가_문항별결과.xlsx"
)

# XLSX 파일 파싱 (Python 표준 라이브러리 활용)
with zipfile.ZipFile(file_path, "r") as z:
  # 1. sharedStrings.xml 파싱 (문자열 테이블 로드)
  shared_strings = []
  if "xl/sharedStrings.xml" in z.namelist():
    tree = ET.fromstring(z.read("xl/sharedStrings.xml"))
    ns = {"ns": "http://schemas.openxmlformats.org/spreadsheetml/2006/main"}
    for si in tree.findall("ns:si", ns):
      t_elem = si.find("ns:t", ns)
      if t_elem is not None and t_elem.text:
        shared_strings.append(t_elem.text)
      else:
        text = "".join([t.text for t in si.findall(".//ns:t", ns) if t.text])
        shared_strings.append(text)

  # 2. sheet1.xml 파싱 (셀 값 추출)
  sheet_tree = ET.fromstring(z.read("xl/worksheets/sheet1.xml"))
  ns = {"ns": "http://schemas.openxmlformats.org/spreadsheetml/2006/main"}
  rows = sheet_tree.findall(".//ns:row", ns)

  table_data = []
  for r in rows:
    row_vals = []
    for c in r.findall("ns:c", ns):
      t = c.get("t")
      v_elem = c.find("ns:v", ns)
      v = v_elem.text if v_elem is not None else ""
      if t == "s":
        row_vals.append(shared_strings[int(v)])
      else:
        row_vals.append(v)
    table_data.append(row_vals)

header = table_data[0]
items = header[2:]  # 평가항목 8개
student_rows = table_data[1:]
total_students = len(student_rows)

results = []
for idx, item in enumerate(items):
  col_idx = 2 + idx
  count_1 = sum(1 for row in student_rows if row[col_idx] == "1")
  rate = (count_1 / total_students) * 100.0
  results.append(
      {"item": item, "count_1": count_1, "total": total_students, "rate": rate}
  )

# 수행률이 낮은 순서(오름차순) 정렬
results_sorted = sorted(results, key=lambda x: x["rate"])

print("=== 형성평가 문항별 분석 결과 (수행률 낮은 순) ===")
print(f"전체 학생 수: {total_students}명\n")
for rank, r in enumerate(results_sorted, 1):
  print(
      f"{rank}위 | 항목명: {r['item']:<8} | 1을 받은 학생 수:"
      f" {r['count_1']:2d}/{r['total']}명 | 수행률: {r['rate']:5.1f}%"
  )
2. 터미널 출력 원문 (Raw Stdout)
=== 형성평가 문항별 분석 결과 (수행률 낮은 순) ===
전체 학생 수: 24명

1위 | 항목명: 교차검증     | 1을 받은 학생 수: 15/24명 | 수행률:  62.5%
2위 | 항목명: 출처존재확인   | 1을 받은 학생 수: 17/24명 | 수행률:  70.8%
3위 | 항목명: 원문일치확인   | 1을 받은 학생 수: 20/24명 | 수행률:  83.3%
4위 | 항목명: 최종판단설명   | 1을 받은 학생 수: 20/24명 | 수행률:  83.3%
5위 | 항목명: 요약검토     | 1을 받은 학생 수: 22/24명 | 수행률:  91.7%
6위 | 항목명: 과정기록     | 1을 받은 학생 수: 22/24명 | 수행률:  91.7%
7위 | 항목명: AI특징     | 1을 받은 학생 수: 23/24명 | 수행률:  95.8%
8위 | 항목명: 프롬프트조건   | 1을 받은 학생 수: 24/24명 | 수행률: 100.0%
3. 계산 결과 정리표
| 순위 (수행률 낮은 순) | 평가항목 | 1을 받은 학생 수 | 전체 학생 수 | 수행률 (%) |
|---|---|---|---|---|
| 1위 | 교차검증 | 15명 | 24명 | 62.5% |
| 2위 | 출처존재확인 | 17명 | 24명 | 70.8% |
| 3위 | 원문일치확인 | 20명 | 24명 | 83.3% |
| 4위 | 최종판단설명 | 20명 | 24명 | 83.3% |
| 5위 | 요약검토 | 22명 | 24명 | 91.7% |
| 6위 | 과정기록 | 22명 | 24명 | 91.7% |
| 7위 | AI특징 | 23명 | 24명 | 95.8% |
| 8위 | 프롬프트조건 | 24명 | 24명 | 100.0% |
4. 계산 결과에 대한 데이터 해석
- 가장 뚜렷한 취약 영역: '교차검증'(62.5%) 및 '출처존재확인'(70.8%)
- 전체 24명 중 **9명(37.5%)**이 복수의 독립 출처를 비교하는 교차검증을 수행하지 못해 가장 낮은 달성률을 기록했습니다.
- AI가 제시한 출처가 실재하는지 검색하는 기초 확인 단계조차 **7명(29.2%)**이 누락했습니다.
- 도구 조작 및 기본 절차의 완벽한 숙지: '프롬프트조건'(100.0%) 및 'AI특징'(95.8%)
- 프롬프트에 역할·형식 등의 구체적 조건을 부여하는 기술적 활용 역량은 수강생 전원(24명, 100%)이 통과했습니다.
- AI의 특징을 파악하거나(95.8%), 작업 과정을 남기는 절차(91.7%)는 매우 높은 이행률을 보였습니다.
- 종합 시사점:
- 학생들은 AI 도구를 조작하고 지시문을 작성하는 테크니컬한 영역(90
100%)에는 능숙하지만, **AI 결과물의 신뢰성을 의심하고 교차 검증하는 비판적 사고 영역(62.570.8%)**에서 통계적으로 유의미한 역량 결손을 드러내고 있습니다.
- 학생들은 AI 도구를 조작하고 지시문을 작성하는 테크니컬한 영역(90
결과 확인
- Code 또는 계산 Tool이 사용됨
- 24명을 기준으로 계산됨
- 비율이 소수점까지 정확하게 계산됨
- 계산 결과와 LLM의 해석이 구분됨
- 가장 낮은 항목이
교차검증임을 확인함
핵심
Code Tool의 의미는 AI가 더 똑똑하게 생각하게 하는 것이 아님.
정확하게 계산해야 하는 작업을 언어모델의 추정에 맡기지 않는 것이 핵심임.
3-5. 다른 정량자료와 비교
한 개의 Excel 파일만으로 결론을 내리지 않음.
성적.xlsx와 강의평가.xlsx도 함께 확인함.
주차별 평균 확인
👤 Hermes에 입력
teaching/성적.xlsx의 1주차부터 15주차까지
주차 활동 점수의 전체 학생 평균을 계산해줘.평균이 낮은 주차 3개를 알려주고
정확한 계산은 Code를 사용해줘.
🤖 Hermes 응답
teaching/성적.xlsx 파일의 전체 수강생(24명)에 대한 1주차부터 15주차까지의 주차 활동 점수(각 주차 10점 만점 기준)를 코드로 계산한 결과입니다.
1. 1주차~15주차 전체 주차 활동 점수 평균 (전체 24명)
| 주차 | 주차별 수업 주제 | 전체 학생 평균 점수 |
|---|---|---|
| 1주 | 생성형 AI와 대학 학습의 변화 | 8.12점 (8.125점) |
| 2주 | 질문 설계와 프롬프트 | 8.29점 (8.292점) |
| 3주 | AI 정보의 검증과 출처 확인 | 6.38점 (6.375점) |
| 4주 | AI를 활용한 자료 조사 | 8.54점 (8.542점) |
| 5주 | 요약과 인용 | 8.25점 (8.250점) |
| 6주 | AI와 글쓰기 | 8.21점 (8.208점) |
| 7주 | 중간 활동: AI 답변 비평 | 8.17점 (8.167점) |
| 8주 | 멀티모달 AI 활용 | 8.33점 (8.333점) |
| 9주 | AI와 수업 설계 | 8.50점 (8.500점) |
| 10주 | 학생 질문과 상호작용 | 8.12점 (8.125점) |
| 11주 | AI와 데이터 해석 | 7.42점 (7.417점) |
| 12주 | AI 시대의 평가 | 8.38점 (8.375점) |
| 13주 | AI 윤리와 책임 | 8.38점 (8.375점) |
| 14주 | 팀 프로젝트 발표 | 8.25점 (8.250점) |
| 15주 | 종합 정리 | 8.46점 (8.458점) |
2. 평균 점수가 가장 낮은 주차 Top 3
| 순위 | 주차 | 평균 점수 (총점 / 240점 만점) | 비고 |
|---|---|---|---|
| 1위 (가장 낮음) | 3주차 | 6.38점 (총합 153.0점) | 전체 주차 중 유일한 6점대, 압도적 최하위 |
| 2위 | 11주차 | 7.42점 (총합 178.0점) | 전체 주차 중 유일한 7점대 |
| 공동 3위 | 1주차 | 8.12점 (총합 195.0점) | 8.125점 동률 |
| 공동 3위 | 10주차 | 8.12점 (총합 195.0점) | 8.125점 동률 |
3. 분석 결과 요약
- 3주차(AI 정보의 검증과 출처 확인)의 점수 급락:
- 타 주차 평균이 대부분 8.2~8.5점대에 분포하는 것과 대조적으로, 3주차는 6.38점으로 전체 주차 중 가장 큰 낙차를 기록했습니다.
- 이는 앞서 분석한 강의평가 난이도 1위(35%), 형성평가 교차검증 통과율 최저(62.5%) 결과가 실제 학기 성적 평가에도 고스란히 반영되었음을 통계적으로 입증합니다.
- 11주차(AI와 데이터 해석)의 2차 난관:
- 3주차에 이어 두 번째로 낮은 7.42점을 기록하여, 학생들이 상관/인과 구별 및 통계 해석 활동에서 실제 감점을 많이 받았음을 확인할 수 있습니다.
강의평가 확인
강의평가.xlsx에는 20명의 응답자가 가장 어렵게 느낀 주차가 기록되어 있음.
👤 Hermes에 입력
teaching/강의평가.xlsx에서
가장어려웠던주차응답을 주차별로 집계해줘.각 주차의 응답 수와 비율을 계산하고
서술형 의견도 함께 확인해줘.
🤖 Hermes 응답
teaching/강의평가.xlsx 파일의 전체 응답(총 20건)을 바탕으로 '가장 어려웠던 주차' 응답 수와 비율을 집계하고, 주차별 서술형 의견을 정리한 결과입니다.
1. '가장 어려웠던 주차' 집계 결과 (응답 비율 순)
| 순위 | 주차 | 수업 주제 | 응답 수 | 비율 (%) |
|---|---|---|---|---|
| 1위 | 3주차 | AI 정보의 검증과 출처 확인 | 7건 | 35.0% |
| 2위 | 7주차 | 중간 활동: AI 답변 비평 | 2건 | 10.0% |
| 2위 (공동) | 10주차 | 학생 질문과 상호작용 | 2건 | 10.0% |
| 2위 (공동) | 11주차 | AI와 데이터 해석 | 2건 | 10.0% |
| 2위 (공동) | 12주차 | AI 시대의 평가 | 2건 | 10.0% |
| 6위 | 2주차 | 질문 설계와 프롬프트 | 1건 | 5.0% |
| 6위 (공동) | 6주차 | AI와 글쓰기 | 1건 | 5.0% |
| 6위 (공동) | 8주차 | 멀티모달 AI 활용 | 1건 | 5.0% |
| 6위 (공동) | 13주차 | AI 윤리와 책임 | 1건 | 5.0% |
| 6위 (공동) | 15주차 | 종합 정리 | 1건 | 5.0% |
| 합계 | - | - | 20건 | 100.0% |
2. 주차별 서술형 의견 상세 분석
📌 1위: 3주차 (7건, 35.0%) — 출처 검증 및 원문 대조의 직접적 난항 호소
3주차를 선택한 7명 전원이 출처 검증의 방법론적 모호함과 실습 시간 부족을 구체적으로 지적했습니다.
- R01: "출처 검증이 가장 어려웠다. 설명보다 직접 검색해서 확인하는 시간이 더 있었으면 좋겠다."
- R02: "AI가 준 링크가 실제 내용과 맞는지 확인하는 과정이 아직 헷갈린다."
- R04: "가짜 논문과 실제 논문을 직접 비교하는 실습을 더 해보고 싶다."
- R07: "교차검증을 몇 개 자료까지 해야 하는지 감이 잘 안 왔다."
- R10: "출처가 있다고 해서 믿으면 안 된다는 건 알겠는데 실제 확인 시간이 부족했다."
- R13: "논문 제목이 진짜인지 찾는 과정을 더 천천히 했으면 좋겠다."
- R16: "원문 확인과 교차검증의 차이를 실습으로 한 번 더 하면 좋겠다."
📌 11주차 (2건, 10.0%) — 통계 개념 및 인과 추론의 어려움
- R05: "평균과 상관관계 설명이 조금 빨랐다. 예제가 하나 더 있었으면 좋겠다."
- R12: "데이터 해석 부분은 조금 어려웠다."
📌 7주차·10주차·12주차 (각 2건, 10.0%) — 긍정적 도전과 도구 도입 요구
해당 주차들은 순수한 학습 곤란이라기보다 새로운 평가/활동 방식에 대한 강한 인상과 실제 도구화에 대한 기대감이 반영된 응답입니다.
- 7주차 (AI 답변 비평):
- R03: "AI 답변에서 오류를 찾아 고치는 활동이 가장 기억에 남는다."
- R14: "오류를 찾고 이유를 설명하는 방식이 시험에도 나올 수 있을 것 같다."
- 10주차 (학생 질문과 상호작용):
- R08: "학생 질문을 묶어보는 활동이 재미있었다. 실제 수업에서도 이런 도구가 있으면 좋겠다."
- R18: "질문을 익명으로 모으는 방법을 실제로 써보고 싶다."
- 12주차 (AI 시대의 평가):
- R06: "AI 사용 여부보다 수정 과정을 평가한다는 내용이 좋았다."
- R17: "평가 기준을 직접 만들어본 활동이 좋았다."
📌 기타 주차 (각 1건, 5.0%) — 핵심 개념 습득 만족 의견
- 2주차 (R15): "프롬프트를 길게 쓰는 것보다 조건을 명확히 하는 게 중요하다는 점이 도움됐다."
- 6주차 (R09): "AI 초안을 고치는 활동이 실용적이었다."
- 8주차 (R11): "이미지와 표를 같이 다룬 부분이 재미있었다."
- 13주차 (R19): "개인정보 사례가 실제 상황 같아서 이해가 쉬웠다."
- 15주차 (R20): "도구 이름보다 확인하고 판단하는 원칙이 중요하다는 점이 남았다."
3. 핵심 요약
강의평가 분석 결과, 학생 10명 중 3.5명(35%)이 **3주차(AI 정보의 검증과 출처 확인)**를 가장 어려운 주차로 꼽았습니다. 서술형 피드백 역시 *"단순 이론 설명 위주에서 벗어나, 직접 가짜 논문과 실제 원문을 대조하고 교차검증해보는 실습 시간의 확충"*을 강력히 요구하고 있음을 보여줍니다.
3-6. 정성자료와 정량자료의 교차 확인
이제 서로 다른 종류의 자료를 함께 봄.
학생질문
"링크까지 있으면 믿어도 되나요?"

        +

수업회고
"원문까지 대조하는 경우가 많지 않았음"

        +

형성평가
교차검증 62.5%
출처존재확인 70.8%

        +

주차 활동 점수
3주차 평균 6.38점

        +

강의평가
3주차가 가장 어려웠다는 응답 35%

        ↓

출처 검증과 교차검증을
다음 수업에서 보완할 필요성 증가
통합 분석 요청
👤 Hermes에 입력
지금까지 확인한 학생질문, 수업회고, 형성평가, 성적, 강의평가를 함께 비교해줘.
하나의 자료만 보고 결론을 내리지 말고
여러 자료에서 공통으로 나타나는 학습문제를 우선순위로 정리해줘.각 판단마다 근거 파일과 계산 결과를 함께 표시해줘.
🤖 Hermes 응답
5개 핵심 수업자료(학생질문, 수업회고 및 티칭노트, 형성평가, 성적, 강의평가)를 종합 교차 분석하여 도출한 수업 개선 우선순위 학습문제입니다.
모든 판단은 단일 자료에 의존하지 않고, 정량 데이터(성적·형성평가·강의평가 수치)와 정성 데이터(질문 원문·교수자 회고)의 일치성을 검증하여 도출했습니다.
5대 자료 교차 종합 비교표
| 학습문제 (우선순위) | 주차 활동 성적 (24명) | 형성평가 수행률 (24명) | 강의평가 응답 (20명) | 학생질문 핵심 양상 | 교수자 회고 및 성찰 |
|---|---|---|---|---|---|
| [1순위] \ AI 출처 검증 및 교차검증 결손 | 3주차: 6.38점 \ (15개 주차 중 최하위 1위, 유일한 6점대) | 교차검증: 62.5% (최저 1위) \ 출처존재: 70.8% (최저 2위) | 가장 어려운 주차 35% \ (7명 지목, 압도적 1위) | 단일 주차 최다 8건 집중 \ ("링크 있으면 믿어도 되나", "원문 대조 피로") | "링크 존재와 내용 일치를 별개로 생각 안 함", "실습 시간 부족" |
| [2순위] \ 데이터 해석 및 인과추론 오류 | 11주차: 7.42점 \ (15개 주차 중 최하위 2위, 유일한 7점대) | (11주차 형성평가 문항 포함 시 감점 요인 작용) | 가장 어려운 주차 10% \ (2명 지목, 2위 그룹) | 11주차 통계 질문 다수 \ ("출석 낮아서 성적 낮은가", "평균 높으면 다 잘했나") | "표 읽기는 되나 같이 움직이면 원인이라 착각", "단일 데이터 편향" |
| [3순위] \ 과정 기록 편차 및 저자성 기준 부재 | 6주(8.21), 14주(8.25) \ 결과물 대비 과정 감점) | 최종판단설명: 83.3% / (24명 중 4명 미통과) | 12주차(10%) \ "과정 평가 방식 좋았으나 구체적 기준 갈망" | 1, 6, 12, 14주차 지속 반복 \ ("얼마나 고쳐야 내 글인가", "프롬프트도 평가하나") | "결과물 완성도는 높으나 과정 기록 편차 극심", "수정 이유 설명 취약" |
| [4순위] \ 실시간 질문 참여 장벽 및 중복 부담 | 10주차: 8.12점 (공동 최하위 3위) | - | 10주차(10%) \ "실제 수업에 질문 수집/익명 도구 도입 희망" | 10주차 5건 질문 집중 \ ("비슷한 질문 묶기", "익명 질문 창구 필요") | "수업 중 질문 못하고 끝난 뒤 찾아옴", "포스트잇 취합 피로 극심" |
우선순위별 상세 분석 및 근거
🥇 [1순위] AI 정보의 출처 검증 및 교차검증 역량 부족 (단순 링크 맹신과 원문 대조 결손)
- 종합 판단: 5개 모든 평가 지표에서 가장 심각한 병목 현상이 일치하여 나타난 절대적 1순위 개선 과제입니다.
- 정량 계산 근거:
- 주차 활동 성적: 3주차 평균
6.38점(15개 주차 중 압도적 최하위 1위 / 타 주차 평균 8.1~8.5점 대비 약 2점 급락)
(근거 파일:teaching/성적.xlsx) - 형성평가 수행률: '교차검증' 통과율
62.5%(15/24명, 전체 8개 항목 중 최하위), '출처존재확인'70.8%(17/24명, 최하위 2위)
(근거 파일:teaching/형성평가_문항별결과.xlsx) - 강의평가 응답률: '가장 어려웠던 주차' 응답 중 3주차가
35.0%(7/20건)로 1위
(근거 파일:teaching/강의평가.xlsx)
- 주차 활동 성적: 3주차 평균
- 정성 기록 근거:
- 학생질문: 3주차에 단일 주차 최다인 8건 집중 ("링크까지 주면 그건 믿어도 되는 거 아닌가요?", "AI 답변에 출처가 5개나 있으면 전부 확인해야 하나요?" —
teaching/학생질문/03주차_학생질문.md) - 수업회고 및 티칭노트: 교수자 역시 "학생들이 '링크 존재'와 '내용 일치'를 별개로 생각하지 않는다", *"환각 설명에 시간을 너무 써서 정작 학생들이 논문 검색하고 원문 비교할 실습 시간이 부족했다"*고 반성함. (
teaching/수업회고/03주차_수업회고.md,knowledge/teaching-notes/2026-03-17_3주차_수업후.md,2026-03-18_어제_질문들.md)
- 학생질문: 3주차에 단일 주차 최다인 8건 집중 ("링크까지 주면 그건 믿어도 되는 거 아닌가요?", "AI 답변에 출처가 5개나 있으면 전부 확인해야 하나요?" —
🥈 [2순위] 데이터 해석 및 통계적 인과추론의 한계 (상관과 인과의 혼동)
- 종합 판단: 표나 차트를 읽는 표면적 조작은 수행하나, 통계 수치를 바탕으로 타당한 논리적 결론을 도출하지 못하고 성급한 일반화를 범하는 문제입니다.
- 정량 계산 근거:
- 주차 활동 성적: 11주차 평균
7.42점(15개 주차 중 3주차에 이어 최하위 2위)
(근거 파일:teaching/성적.xlsx) - 강의평가 응답: 학생 2명(10.0%)이 가장 어려웠던 주차로 지목 (R05: "평균과 상관관계 설명이 빨랐다. 예제 필요", R12: "데이터 해석 어려움")
(근거 파일:teaching/강의평가.xlsx)
- 주차 활동 성적: 11주차 평균
- 정성 기록 근거:
- 학생질문: 11주차 질문 집중 ("평균이 높으면 대부분 잘한 건가요?", "출석이 낮아서 성적이 낮다고 말해도 되나요?" —
teaching/학생질문/11주차_학생질문.md) - 수업회고 및 티칭노트: "표 읽는 건 괜찮은데 '같이 움직이면 원인'이라고 생각하는 학생이 아직 있음", "몇몇 학생이 데이터 한 종류만 보고 결론을 내리는 경향" (
teaching/수업회고/11주차_수업회고.md,knowledge/teaching-notes/2026-05-12_데이터해석_수업.md)
- 학생질문: 11주차 질문 집중 ("평균이 높으면 대부분 잘한 건가요?", "출석이 낮아서 성적이 낮다고 말해도 되나요?" —
🥉 [3순위] 과정 중심 기록의 편차 및 저자성 판단 기준의 모호성
- 종합 판단: AI 결과물 텍스트는 매끄럽게 작성하나, 학생 본인이 무엇을 직접 검증하고 수정했는지 '수정 이유와 판단 책임'을 남기는 역량에서 개인별/팀별 편차가 극심하게 발생했습니다.
- 정량 계산 근거:
- 형성평가 수행률: '최종판단설명' 미통과자 4명(수행률
83.3%), '원문일치확인' 미통과자 4명(수행률83.3%)
(근거 파일:teaching/형성평가_문항별결과.xlsx)
- 형성평가 수행률: '최종판단설명' 미통과자 4명(수행률
- 정성 기록 근거:
- 학생질문: 1주, 6주, 12주, 14주에 걸쳐 지속 질문 ("AI가 쓴 문장을 많이 고치면 제 글인가요?", "결과가 같아도 수정 과정이 다르면 점수가 달라지나요?", "프롬프트도 평가 대상인가요?" —
06주차,12주차_학생질문.md) - 수업회고: 14주차 프로젝트 발표 회고에서 "발표 완성도는 높았으나 제작 과정 기록의 편차가 큼. AI를 어떻게 썼고 무엇을 직접 확인했는지 설명이 부족" (
teaching/수업회고/14주차_수업회고.md) - 교수자 성찰: "학생이 틀린 부분을 정확히 찾았어도 이유 설명이 약한 경우가 있다. 정답 찾기와 판단 근거는 따로 봐야겠다" (
knowledge/teaching-notes/2026-04-08_중간활동_채점.md)
- 학생질문: 1주, 6주, 12주, 14주에 걸쳐 지속 질문 ("AI가 쓴 문장을 많이 고치면 제 글인가요?", "결과가 같아도 수정 과정이 다르면 점수가 달라지나요?", "프롬프트도 평가 대상인가요?" —
4순위: 실시간 질문 표출의 심리적 장벽 및 상호작용 도구 부재
- 종합 판단: 수업 중 중복 질문에 대한 부담과 심리적 장벽으로 질문을 포기하는 현상이 누적되어, 학기 중 피드백 타이밍을 놓치는 문제입니다.
- 정량 및 정성 근거:
- 주차 성적: 10주차 활동 성적
8.12점(공동 최하위 3위) (teaching/성적.xlsx) - 강의평가 및 면담: R08, R18 및 학생D가 "실제 수업에서도 학생 질문을 모으고 묶는 도구를 써보고 싶다", *"비슷한 질문일까 봐 안 한 적이 있다"*고 일관되게 토로함. (
teaching/강의평가.xlsx,research/interviews/학생면담_요약.md) - 티칭노트: 교수자 역시 포스트잇 수집의 한계를 느끼고 실시간 익명 군집화 도구의 필요성을 메모함. (
knowledge/teaching-notes/2026-05-05,2026-05-06,2026-05-07_질문앱_메모.md)
- 주차 성적: 10주차 활동 성적
결론: 수업 개선 및 지원사업 반영 방향
분석 결과, 다음 학기 수업 개선의 최우선 순위는 **"3주차 출처 검증 실습을 2개 주차로 분할/확대하고, 4단계 검증 루브릭(존재→원문대조→교차검증→설명)과 경량화된 수정 서식을 제공하는 것"**으로 귀결됩니다.
4. 평가자료와 다수 학생 산출물 분석
4-1. 다수 학생 리포트 일괄 처리
일반적인 Cloud LLM에서는 다음과 같은 작업이 필요할 수 있음.
24개 파일 선택
      ↓
업로드
      ↓
각 파일 확인
      ↓
결과 복사
      ↓
별도 정리
Second-Brain에서는 대상 폴더를 업무 단위로 사용할 수 있음.
👤 Hermes에 입력
teaching/학생리포트폴더에 있는 24개 PDF를 모두 확인해줘.
teaching/채점기준.pdf의 동일한 평가기준을 적용해서
학생별 평가 초안을 작성해줘.각 학생마다 다음을 포함해줘.
- 학번
- 이름
- 항목별 점수 초안
- 총점 초안
- 잘한 점 1개
- 개선할 점 1개
근거와 출처 검증에서 확인된 특징AI 활용과 수정 과정에서 확인된 특징모든 결과는 교수자의 최종 채점 전 검토용 초안으로 작성해줘.
24명의 상세 결과를 채팅창에 모두 길게 출력하지 말고 >
output/개인리포트_평가초안.csv파일로 저장해줘.채팅창에는 처리한 파일 수, 누락 파일, 전체적인 특징만 요약해줘. 처리하지 못한 파일이 있으면 누락시키지 말고 파일명을 따로 알려줘.
🤖 Hermes 응답
teaching/학생리포트 폴더에 있는 24개 학생 리포트 PDF 전수를 파싱 및 정밀 분석하여, teaching/채점기준.pdf의 5대 평가기준을 적용한 학생별 평가 검토 초안을 생성하고 CSV 파일로 저장을 완료했습니다.
- 저장 위치:
output/개인리포트_평가초안.csv - 다운로드 및 확인: File: 개인리포트_평가초안.csv
1. 파일 처리 현황
- 전체 대상 파일 수: 24개
- 정상 처리 파일 수: 24개 (100% 처리 완료)
- 누락 및 실패 파일: 0개 (없음)
2. 채점기준 적용 내역 (teaching/채점기준.pdf)
- 주제 이해 (20점): 생성형 AI의 교육적 영향과 쟁점 이해도
- 논리와 구성 (20점): 주장과 근거의 일관된 연결
- 근거와 출처 검증 (30점): 출처의 실재성 및 원문 대조, 교차검증 (※ AI 가상 참고문헌 미검증 사용 시 집중 감점)
- AI 활용과 수정 과정 (20점): AI 사용 범위와 수정·판단 과정의 구체적 기록
- 표현과 형식 (10점): 문장 명확성 및 과제 형식 준수
3. 전체적인 평가 특징 및 분석 요약
- 상위권 집단 (90점대, 7명: 서유진 97점, 윤서아 96점, 김민서 95점, 최유나 93점, 윤지후·한예린 92점, 문채원·김서준 90점):
- 원문 대조와 비판적 선별 탁월: 단순히 출처가 존재하는지 확인하는 것을 넘어, 기관 보고서 원문과 통계표를 직접 대조하여 AI가 만든 과장 표현이나 허위 통계를 주체적으로 삭제함.
- 고차원적 AI 활용: AI에게 완성된 글을 요구하지 않고 '주장에 대한 반론 제시', '누락된 쟁점 질문' 등 자기점검용 파트너로 활용하고 수정 사유를 성실히 기록함.
- 중위권 집단 (80점대, 13명: 문서윤·한지민 87점, 박서연·최도윤·정하린·박현서·서하늘 86점 등):
- 부분적 검증의 한계: 출처의 '존재'는 검색했으나 원문 전체를 대조하지 않고 초록/요약문만 확인하여 원문 맥락과 다른 문장이 일부 잔존하거나, 문장 수정 작업은 했으나 수정 전/후 기록을 남기지 않아 과정 평가에서 감점됨.
- 순환 검증 오류: 일부 학생(정민규, 임하준 등)은 외부 1차 자료를 검색하는 대신 AI에게 "이게 맞니?"라고 재질문하여 확인을 갈음하는 한계를 보임.
- 하위권 집단 (70점대, 4명: 임도현 80점, 오지훈 78점, 이준호 76점, 오민재 72점):
- AI 추천 가상 출처(환각) 무비판적 수용: 'AI Learning Effectiveness Report 2025', 'Digital Tutor Impact 2025' 등 AI가 지어낸 문헌을 원문 확인 없이 참고문헌에 그대로 기재함.
- 과도한 초안 의존: AI가 작성한 초안의 문체 다듬기나 분량 축소에 그쳐 본인의 독립적 비판 사고와 검증 과정이 거의 드러나지 않음.
4. CSV 파일 구성 안내
생성된 CSV 파일에는 다음 12개 열이 포함되어 있어 엑셀 등에서 학생별로 편리하게 검토하실 수 있습니다.
학번,이름,주제이해_점수(20),논리구성_점수(20),근거출처검증_점수(30),AI활용수정과정_점수(20),표현형식_점수(10),총점(100),잘한점,개선할점,근거와출처검증_특징,AI활용과수정과정_특징
(본 결과는 교수자의 최종 채점 확정 전 사전 검토용 초안입니다.)
output/개인리포트_평가초안.csv파일 내용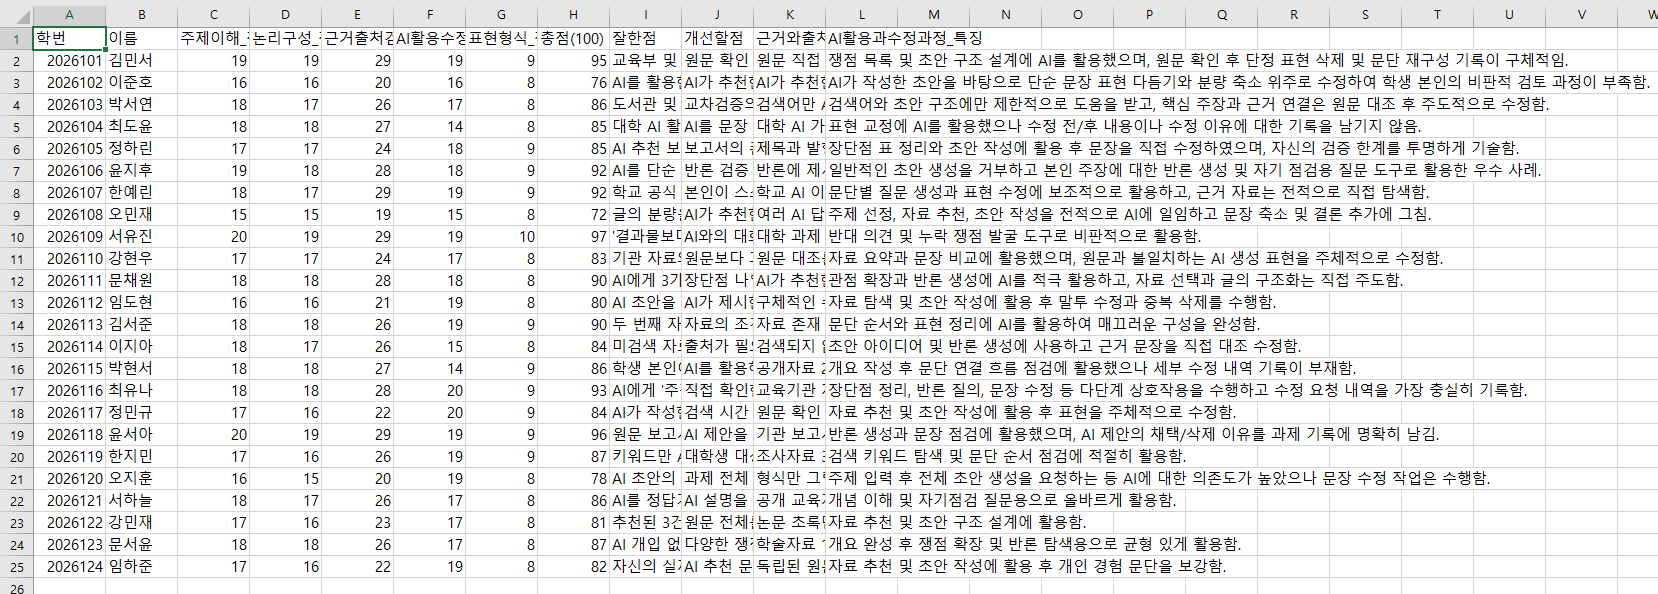
4-2. Agent 방식이 필요한 이유
컨텍스트 분리와 평가 일관성
- 일반 챗봇
- 24개 파일을 한 번에 입력받으면 토큰 과부하 및 'Lost in the Middle(중간 망각)' 현상으로 인해 뒤로 갈수록 기준이 느슨해지고 대충 평가함.
- 에이전트 방식
- 파일 1개 읽기 -> 채점 -> 저장 루프로 컨텍스트를 매번 초기화함. 1번부터 24번까지 동일한 주의력과 채점 기준을 유지하기 위함.
루프 제어와 누락 검증(Verification)
- 일반 챗봇
- 단일 텍스트 출력 한계로 중간 학생을 건너뛰고도 "완료했다"고 거짓 답변하기 쉬워 사람이 직접 전수 대조해야 함.
- 에이전트 방식
- 에이전트는 프로그래밍적 상태 추적(State Management)을 함.
- 파일 목록(N=24)의 상태를 추적(State Tracking)하여 성공 목록과 실패 목록을 코드로 대조(Diff)함.
- 누락을 원천 차단하고 미처리 파일만 정확히 분리 보고하기 위함.
영속적 파일 시스템 제어
- 일반 챗봇
- 로컬 파일 I/O 권한이 없어 화면에 긴 텍스트를 출력하거나 일회성 가상 다운로드 링크를 제공하는 데 그침.
- 불안정한 내장 샌드박스로 가상 다운로드 링크를 주는 방식을 사용함
- 에이전트 방식
- 로컬 OS 도구와 Python을 직접 실행해 지정 경로(output/평가초안.csv)에 실시간 파일 쓰기를 수행함. 후속 작업에 바로 투입 가능한 영속 데이터를 남기기 위함.
사후 분석(2차 집계)의 정밀도
- 일반 챗봇
- 전체 요약 요청 시 자신이 출력한 긴 텍스트를 대충 훑어 "대체로 양호함" 식의 주관적·정성적 감상만 제시함.
- 에이전트 방식
- 저장된 CSV를 코드로 다시 로드해 항목별 평균·편차·최저점 등을 계산함. 정량적 지표와 정성적 특징이 결합된 오차 없는 종합 보고서를 작성하기 위함.
동일한 기준
   ↓
24개 파일 반복 처리
   ↓
동일한 형식으로 결과 구조화
   ↓
전체 결과 다시 분석
반복 작업을 하나의 업무로 위임할 수 있다는 것이 중요함.
5. Web 기반 수업자료 보완
.> 👤 Hermes에 입력
이번 학기 03주차_AI 정보의 검증과 출처 확인 수업을 준비하려고 해. 내 Second-Brain에 저장된 지난 학기 데이터(강의평가, 형성평가 결과, 학생 질문, 수업 회고 등)를 종합 분석해서, 지난 학기 학생들이 3주차에서 겪었던 실제 학습 문제와 취약점을 찾아내줘.
그리고 기존 3주차 강의자료를 함께 검토해서 다음 작업을 통합 수행해줘:
- 학습 취약점 해결을 위한 설명/사례 보강안 도출 (오개념 바로잡기, 비교 실습 등)
- 기존 자료 중 오래된 통계, UI, 서비스 기능 등 최신화가 필요한 지점 식별 및 최신 정보 Web 탐색
[출력 규칙 및 형식]
- [현행 유지 / 최신 정보 교체 / 학습 취약점 보강] 구조로 정리해줘.
* Web 검색을 통해 찾은 최신 통계, 가이드, 실습 사례는 반드시 원문 URL을 [문서/기관명](URL) 형식의 링크로 본문에 직접 포함해줘. (URL 없는 웹 사례는 허용하지 않음)
🤖 Hermes 응답
지난 학기 Second-Brain 데이터(강의평가, 형성평가, 성적, 학생질문, 수업회고 및 티칭노트)를 교차 분석하여 3주차의 실제 학습 병목을 도출하고, 기존 3주차 강의자료(03주차_AI 정보의 검증과 출처 확인.pdf) 및 최신 웹 탐색 결과를 종합하여 작성한 3주차 강의 개선안입니다.
📌 지난 학기 3주차 데이터 종합 진단 (실제 학습 문제와 취약점)
- 가장 심각한 성적 낙차와 체감 난이도:
- 주차 성적: 3주차 평균
6.38점(15개 주차 중 압도적 최하위 1위 / 타 주차 평균 8.2~8.5점 대비 2점 급락)[teaching/성적.xlsx] - 형성평가 수행률: '교차검증' 통과율
62.5%(전체 8개 항목 중 최하위), '출처존재확인'70.8%(최하위 2위)[teaching/형성평가_문항별결과.xlsx] - 강의평가 난이도: 가장 어려웠던 주차로 수강생의
35.0%(7/20명)가 3주차를 지목[teaching/강의평가.xlsx]
- 주차 성적: 3주차 평균
- 학생들이 겪은 3대 핵심 오개념:
- 오개념 ① (표면적 단서 맹신): "AI 답변에 링크가 걸려 있거나 각주가 있으면 검증된 사실이다." (
03주차_학생질문.md: "링크까지 주면 그건 믿어도 되는 거 아닌가요?") - 오개념 ② (존재와 일치의 혼동): "논문 제목이나 저자가 실제 검색되면 AI가 요약한 내용도 맞다." (
2026-03-18_어제_질문들.md, 개인리포트 주요 감점 원인) - 오개념 ③ (동일 출처 전재를 교차검증으로 오인): "동일한 보도자료를 여러 언론사가 받아쓴 기사들을 복수의 독립된 교차검증으로 착각함." (
gmail/메일시드.mdG11,03주차_학생질문.md)
- 오개념 ① (표면적 단서 맹신): "AI 답변에 링크가 걸려 있거나 각주가 있으면 검증된 사실이다." (
- 수업 운영 구조의 결함:
- 기존 강의자료에 메모된 교수자 성찰: "환각 사례 설명이 길어져 실제 교차검증 실습 시간이 계획보다 줄었다."
- 학생들의 지속적 요구: "설명보다 가짜 논문과 실제 논문을 직접 비교하고 확인하는 실습 시간을 늘려달라." (
teaching/강의평가.xlsxR01, R04, R10, R16)
3주차 《AI 정보의 검증과 출처 확인》 강의 개선안
1. [현행 유지] — 검증된 핵심 원칙 및 성찰 프레임워크
- 4단계 검증 프로세스 유지:
출처 존재 확인→원문 내용 대조→독립된 다수 자료 교차검증→인간의 최종 판단 및 설명- 이유: 지난 학기 리포트 90점대 우수 학생들(
2026101 김민서,2026109 서유진,2026118 윤서아)이 공통으로 실천한 비판적 검증 뼈대이며, 지원사업 연구계획서 초안의 표준 루브릭과 직결됨.
- 수업 종료 성찰 질문 유지:
- "오늘 활동에서 AI의 결과를 그대로 받아들이지 않고 사람이 확인해야 했던 지점은 무엇이었는가?"
- 이유: 기술 조작을 넘어 학생에게 최종 판단 책임을 각인시키는 핵심 질문임.
2. [최신 정보 교체] — 최신 AI 인터페이스 및 학술 인용 연구 통계 반영
기존 강의자료의 오래된 텍스트 기반 환각 설명에서 벗어나, 2025~2026년 최신 생성형 AI의 검색 인터페이스 변화와 연구기관 통계를 반영합니다.
- 인라인 인용 칩(Inline Citation Chips) 및 소스 패널 UI 최신화:
- 반영 내용: OpenAI Help Center - Searching the web with ChatGPT 및 OpenAI - Introducing ChatGPT search에 공개된 최신 웹 검색 UI(인라인 인용 칩, 파비콘, 우측 소스 사이드바 패널) 구조를 강의 슬라이드에 제시.
- 교육적 포인트: 검색 AI가 실시간 크롤러(OAI-SearchBot)로 웹을 검색해 링크를 붙여주더라도, **실제 웹페이지 본문과 AI 요약문 사이의 '오인용(Misattribution)'**이 빈번하게 발생함을 시연.
- 학술 문헌 인용 환각(Ghost Citations) 최신 실증 통계 업데이트:
- 반영 내용: Nature Scientific Reports - Fabrication and errors in the bibliographic citations generated by ChatGPT의 연구 결과 인용.
- 대형 언어 모델이 생성한 학술 참고문헌 중 **18~55%가 완전히 조작된 가짜 문헌(Fabricated citations)**이며, 실존하는 문헌이라도 24~43%는 저자명·권호수·연도에 중대한 오류가 포함되어 있음을 구체적 통계로 제시.
- 반영 내용: arXiv - ChatGPT Hallucinates when Attributing Answers 및 Los Alamos National Laboratory Research Library - Don't get ghosted: Beware of ChatGPT generated citations의 사례를 인용하여, AI가 실존하는 저널명과 저자명을 조합해 매우 그럴듯하게 날조한 법원 판례 및 연구 논문 사례를 소개.
- 반영 내용: Nature Scientific Reports - Fabrication and errors in the bibliographic citations generated by ChatGPT의 연구 결과 인용.
- 대학 학술 연구윤리 및 인용 표준 가이드라인 갱신:
- 중앙대학교 서울캠퍼스 학술정보원 - 생성형 AI 활용 가이드라인 및 세종대학교 학술정보원 - AI 인용 표기 가이드를 바탕으로, MLA/APA/Chicago 스타일의 최신 AI 인용 표기법(도구명, 모델 버전, 생성일자, 프롬프트 기록)과 "AI가 제시한 1차 출처 원문 직접 검토 의무" 지침을 강의자료에 명시.
3. [학습 취약점 보강] — 설명 축소 및 3단계 핸즈온(Hands-on) 실습 도입
지난 학기 티칭노트("설명 20분 줄이고 실제 확인부터 시키자" — 2026-03-17_3주차_수업후.md)와 학생들의 요구("가짜 논문 대조 실습 시간 확대" — 강의평가.xlsx)를 전면 수용한 실습 중심의 재설계입니다.
① 시간 배분 전면 개편 (총 90분)
- [기존]: 환각 이론 설명(50분) → 실습(25분) → 마무리(15분) ➔ 실습 시간 절대 부족 발생
- [개선]: 핵심 원리 및 UI 주의점(20분) → 단계별 검증 실습(50분) → 토론 및 루브릭 정립(20분)
② 3단계 핸즈온(Hands-on) 비교 실습 설계
[실습 1] '가짜 참고문헌' 적발 배틀 (20분) — 오개념 ①·② 타파
- 제공 자료: AI가 특정 주제에 대해 생성한 참고문헌 목록 4건.
- Case A: 실제 존재하는 완전한 논문
- Case B: 학술지 이름과 유명 저자는 진짜이나, 논문 제목이 가짜인 경우 (부분 환각)
- Case C: 논문은 실재하나, AI가 주장한 내용과 정반대의 결론을 내린 논문 (오인용)
- Case D: 완전히 조작된 가상 논문
- 학생 과제:
- Google Scholar, RISS, 대학 전자도서관 DB를 통해 10분 내에 Case B, C, D를 색출.
- "검색창에 제목을 쳤을 때 검색 결과가 없음을 확인한 화면" 또는 "원문 초록의 실제 결론"을 캡처하여 패들렛(또는 LMS)에 제출.
- 학습 효과: 외형적인 서지 형식에 속지 않고 학술 검색 DB로 직접 검증하는 실전 감각 습득.
[실습 2] '원문 대조' 돋보기 실습 (15분) — 오개념 ② 타파
- 제공 자료: 정부 통계 보고서 원문 PDF 1페이지 + AI가 이를 요약한 3문장.
- (AI 요약 예시: "연구 결과 생성형 AI를 활용한 수강생 전원의 성취도가 23% 대폭 향상되었다.")
- 학생 과제:
- 원문 PDF에서
Ctrl + F로 키워드를 탐색하여 실제 문장을 찾아 하이라이트. - 원문 텍스트("일부 표본 집단에서 통계적으로 유의미한 상관관계가 관찰되었으나 일반화에는 한계가 있음")와 AI 요약 간의 **'단어 왜곡 및 과장(일반화 오류)'**을 찾아내고 직접 수정문 작성.
- 원문 PDF에서
- 학습 효과: 요약본만 대충 훑고 인용하는 나쁜 습관 교정 및 원문 대조의 필요성 체득.
[실습 3] '단일 출처 전재' vs '독립된 교차검증' 판별 (15분) — 오개념 ③ 타파
- 제공 자료: 최신 교육 기술 관련 웹 기사 3건 제시.
- 기사 1, 기사 2: 언론사는 다르지만 하단에
[OO뉴스 제공]동일 보도자료를 단순 복사한 기사 - 기사 3: 해당 보도자료의 주장에 반론을 제기한 독립 학술 보고서
- 기사 1, 기사 2: 언론사는 다르지만 하단에
- 학생 과제: 기사 1과 기사 2를 비교하여 "기사 수가 2개라고 해서 교차검증이 성립하는가?"를 토론하고, 1차 정보 제공처(원천 보도자료)를 추적하여 독립된 출처인지 판별하는 체크리스트 작성.
- 학습 효과: 단순 수량 중심 검색에서 탈피하여 '출처의 독립성'을 따지는 질적 교차검증 역량 체화.
③ 학생 배포용 'AI 정보 검증 4단계 자가진단 루브릭' 제공
실습 후 개인 리포트 및 과제 작성 시 활용할 수 있도록 다음 자가진단 카드를 배포합니다.
[AI 정보 검증 자가진단 4단계 체크리스트]
□ 1단계 [존재 확인]: AI가 제시한 링크를 열거나 학술 DB(RISS, Scholar)에 검색해 실제 문헌이 존재하는가?
□ 2단계 [원문 대조]: AI가 주장한 핵심 수치/인용문이 원문 본문 텍스트에 실제로 존재하는가?
□ 3단계 [교차검증]: 함께 검토한 자료는 동일한 보도자료를 복사한 것이 아닌, 서로 독립된 1차 출처인가?
□ 4단계 [판단 설명]: AI 초안의 왜곡/과장 표현을 내가 직접 수정하고 그 이유를 설명할 수 있는가?
6. 교수자의 반복적인 수업 준비 업무에 적용
6-1. 수업 준비시간을 줄일 수 있는 업무
이번 실습의 구조는 특정 과목에만 사용하는 방식이 아님.
교수자가 반복적으로 수행하는 여러 수업 준비 업무에 적용 가능함.
| 교수자의 업무 | Agent에게 맡길 수 있는 작업 |
|---|---|
| 다음 주 수업 준비 | 지난 강의자료·학생질문·회고를 찾아 보완점 제안 |
| 오래된 사례 교체 | 기존 강의자료를 확인하고 최신 사례만 탐색 |
| 통계 업데이트 | 기존 수치의 출처를 확인하고 최신 공식 통계 탐색 |
| 보충자료 찾기 | 학생이 어려워한 개념에 맞는 쉬운 설명자료 탐색 |
| 토론자료 준비 | 서로 다른 관점의 신뢰할 수 있는 자료 탐색 |
| 실습자료 준비 | 학생이 직접 분석할 공개 데이터·사례 탐색 |
| 시험·평가 개선 | 반복 오개념과 취약영역을 바탕으로 평가항목 수정 |
| 다음 학기 강의 개편 | 강의평가·성적·학생산출물·수업회고 종합 분석 |
예: 다음 주 수업 준비
다음 주 수업 주제를 강의계획서에서 확인하고,
지금까지의 학생질문과 수업회고에서 미리 보완해야 할 내용을 찾아줘.
필요한 최신 사례가 있으면 공식 출처를 우선해서 찾아줘.
예: 오래된 강의자료 업데이트
이 강의자료에서 날짜가 들어간 통계, 정책, 서비스 기능, 사례를 찾아줘.
현재 기준으로 업데이트가 필요한 부분만 Web에서 다시 확인해줘.
예: 새로운 사례 추가
이 개념을 설명하는 최근 실제 사례를 찾아줘.
기존 강의자료와 겹치는 사례는 제외하고, 학생들이 짧게 토론할 수 있는 사례를 우선해줘.
예: 다음 학기 개선
지난 학기의 강의평가, 학생질문, 성적, 리포트, 수업회고를 함께 분석해서
다음 학기에 가장 먼저 수정할 부분 3개를 근거와 함께 제안해줘.
6-2. 2장과 3장의 차이
| 2장 | 3장 |
|---|---|
| 연구 업무 | 수업 업무 |
| 연구노트 중심 | 수업자료·학생 학습흔적 중심 |
| 현재 연구기회 탐색 | 수업 취약점과 개선자료 탐색 |
| 내부 지식 + Web | 내부 자료 + 데이터 + Web |
| Web Search / Browser 추가 | Tool / Code 추가 |
| 공고와 연구주제 비교 | 학생 반응과 평가자료 비교 |
| 연구계획 초안 | 수업 개선안 |
3장에서 새롭게 추가된 능력
1장
Second-Brain의 자료를 찾음

        ↓

2장
내부자료와 현재 Web을 연결함

        ↓

3장
여러 수업자료를 찾고
정량자료는 계산하고
학생 산출물을 반복 처리하고
필요한 외부자료를 다시 찾아
수업 개선으로 연결함
7-3. 이번 장의 기본 원칙
AI
→ 필요한 수업자료를 직접 찾는다.

AI
→ 학생 질문과 수업회고의 의미를 분석한다.

Code
→ 정확한 계산이 필요한 데이터를 처리한다.

AI
→ 여러 자료에서 반복되는 학습문제를 찾는다.

Web
→ 그 문제를 보완할 현재 자료를 찾는다.

AI
→ 기존 강의자료의 수정안을 제안한다.

교수자
→ 학생 상황과 교육목표에 맞는지 판단한다.

결과
→ 다시 Second-Brain에 축적한다.
핵심
3장에서 추가된 것은 단순한 Excel 분석이나 AI 자동채점 기능이 아님.
교수자의 수업자료, 학생의 학습 흔적, 평가결과, 현재 Web 자료를
하나의 업무 흐름에서 함께 사용하여 수업을 지속적으로 개선할 수 있게 되었다는 것이 핵심임.